
Nel contesto della moderna radiodiagnostica, l’integrazione dell’intelligenza artificiale nei workflow clinici rappresenta una svolta operativa, che richiede al Tecnico Sanitario di Radiologia Medica l’integrazione di concetti profondamente innovativi, correlati al costante upgrade tecnologico.
A questo scopo è fondamentale definire che cos’è un Foundation Model.
Immaginiamo di voler insegnare a un computer a identificare una frattura costale su una radiografia del torace. Con i vecchi sistemi, dovevamo prendere un algoritmo completamente “vuoto” e mostrargli decine di migliaia di radiografie del torace spiegate punto per punto. Se il giorno seguente volevamo che riconoscesse invece una frattura del femore, l’algoritmo non poteva riutilizzare nulla di ciò che aveva imparato, dovendo dunque azzerarlo e ripartire da capo con altrettante radiografie di femore.
Un Foundation Model è esattamente questo: una rete neurale già “formata”, addestrata su milioni di immagini per comprendere l’anatomia, i contorni e le forme convenzionali.
Quando lo si vuole usare per un compito specifico (come individuare un addensamento polmonare o una lesione ossea), non serve riaddestrarlo da capo: ha già le basi pronte e richiede soltanto un piccolissimo “ritocco” finale per assolvere alla sua funzione.
Tuttavia, nell’ambito dell’analisi radiografica, anche i foundation models tradizionali possono cadere nella trappola dello shortcut learning (apprendimento per scorciatoie), fenomeno che si verifica quando una rete neurale associa una diagnosi ad elementi non anatomici ed estranei alla patologia.
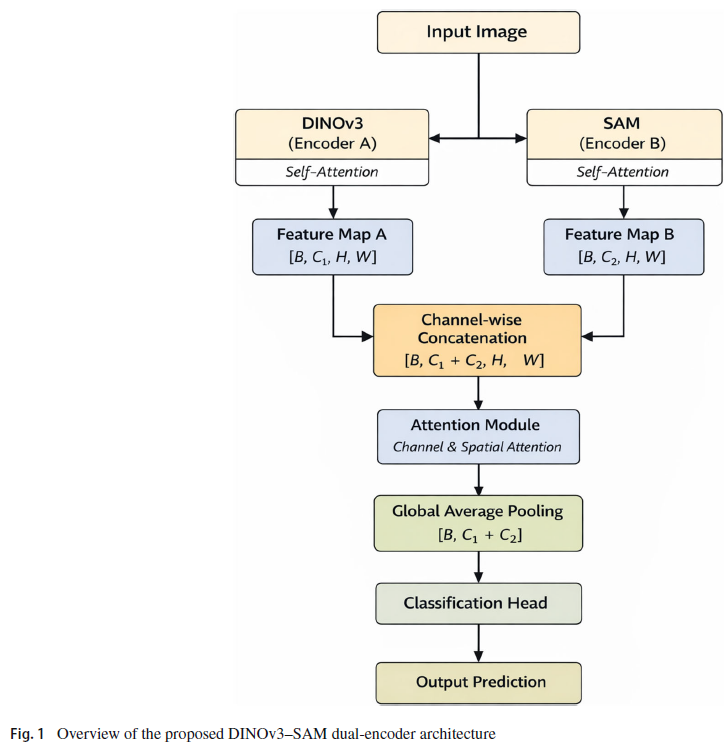
Per superare questo limite e impedire quindi che l’algoritmo venga fuorviato da artefatti od oggetti estranei, lo studio “DINOv3–SAM: Fusing Semantic and Anatomical Foundation Models for Robust Medical Image Classification” , pubblicato da Saeed Al Gharib e collaboratori sul “Journal of Imaging Informatics in Medicine” propone un’architettura duale basata su Vision Transformer, architetture basate su meccanismi d’attenzione capaci di modellare le relazioni spaziali globali dell’immagine e di unire la comprensione semantica globale di DINOv3 alla localizzazione precisa dei contorni anatomici fornita dal Segment Anything Model.
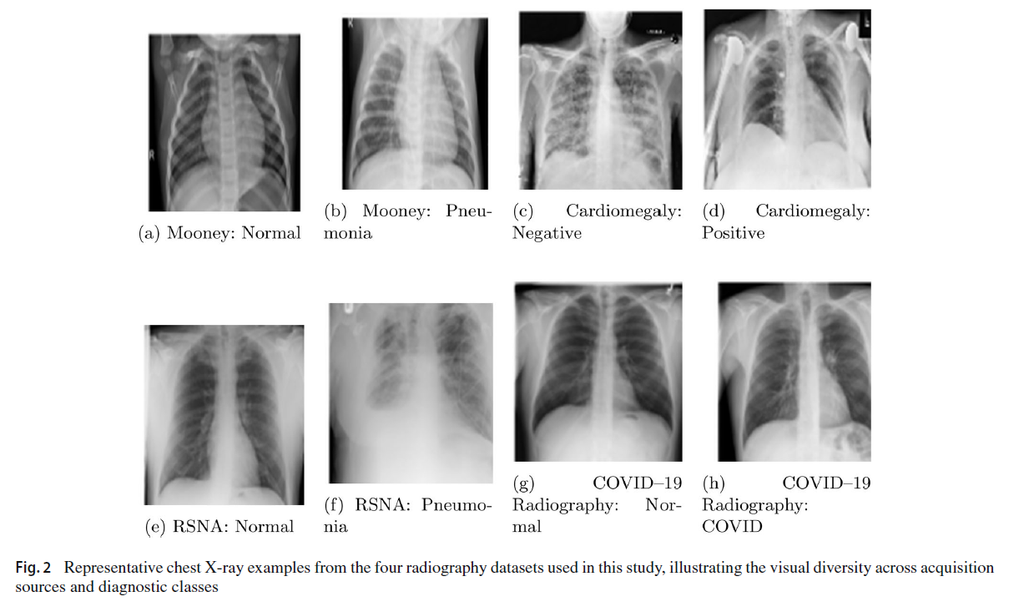
Le metodiche d’immagine analizzate nello studio coprono sia la radiografia del torace (Chest X-Ray, CXR) sia la fotografia dermoscopica, dimostrando l’efficacia della rete su differenti apparecchiature e distretti corporei.
Analizzando i parametri di scansione, matrice e pre processing, lo studio evidenzia come l’immagine radiologica grezza debba essere armonizzata prima del post processing.
Il file d’ingresso viene processato a due risoluzioni spaziali differenti per alimentare le due branche dell’architettura: la branca semantica DINOv3 lavora su una matrice d’ingresso ridimensionata a 224×224, mentre la branca anatomica SAM richiede una matrice ad alta risoluzione di 1024×1024.
Durante il processo di addestramento viene applicata una pipeline di data augmentation basata su rotazioni casuali, ribaltamenti orizzontali e variazioni d’intensità della scala dei grigi, affiancata da algoritmi di normalizzazione. Per il TSRM è essenziale, in questa fase, il significato che tali trasformazioni manifestano, simulando ed equilibrando le fluttuazioni di contrasto e densità legate alle differenti scelte di Kv, mAs, filtraggio e distanza fuoco – film.
Comprendere il funzionamento di modelli avanzati come DINOv3–SAM, consente al TSRM di collocare il proprio operato all’interno di un percorso clinico orientato all’eccellenza.
Sapere che l’intelligenza artificiale possa essere, ad esempio, ingannata dallo shortcut learning, riduce il rischio di automation bias e over reliance.
Fonte: Al Gharib S, Dornaika F, Charafeddine J, Haddad S. DINOv3–SAM: Fusing Semantic and Anatomical Foundation Models for Robust Medical Image Classification. J Imaging Inform Med. 2026; doi:10.1007/s10278-026-02405-0.
