
L’elettrocardiogramma, definito come la registrazione grafica dell’attività elettrica del cuore in funzione del tempo, rappresenta uno strumento fondamentale per la diagnosi delle aritmie cardiache, ovvero le alterazioni del normale ritmo sinusale.
Se in ambito ospedaliero l’acquisizione dell’ECG avviene in condizioni standardizzate, l’impiego crescente di dispositivi indossabili, consente oggi un tracciato continuo nella vita quotidiana dei pazienti affetti da aritmia e il cui ritmo cardiaco deve essere monitorato costantemente.
Tuttavia, il monitoraggio out of hospital espone il segnale a forti interferenze, causate dalla contrazione muscolare, dal movimento corporeo o dal difettoso contatto degli elettrodi con la cute.
In questo contesto, un falso positivo si verifica quando l’algoritmo di base del dispositivo scambia un semplice artefatto per un’aritmia vera, saturando la memoria limitata del sensore e generando falsi allarmi che appesantiscono la successiva revisione del tracciato.
Per risolvere questa criticità, uno studio scientifico pubblicato sulla rivista Computer Methods and Programs in Biomedicine da Guzmán-García C, Martini C. e collaboratori, ha valutato l’efficacia di modelli di Machine Learning e Deep Learning dedicati all’identificazione del rumore.
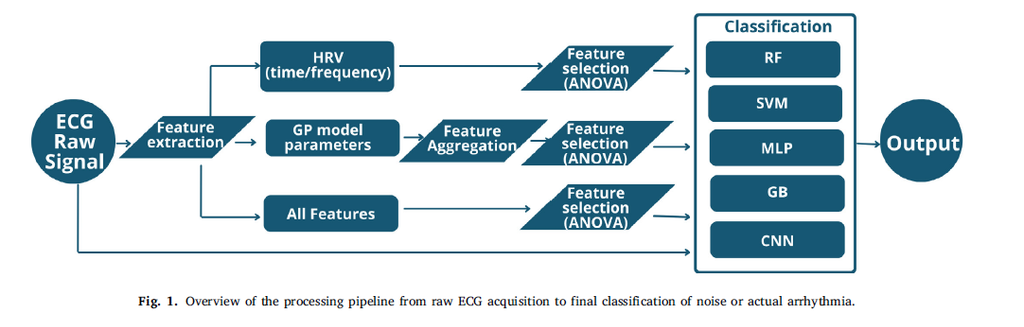
La ricerca si è basata su dati reali raccolti sul campo tramite un dispositivo indossabile chiamato Ritmia, in grado di registrare segmenti ECG a una frequenza di campionamento di 125 Hz per una durata di 6 secondi, corrispondenti a 750 campioni di ampiezza.
Il dataset analizzato ha compreso 2088 segmenti complessivi, suddivisi in 1165 aritmie vere e 925 segnali rumorosi. L’obiettivo primario degli autori non è stato la diagnosi dell’aritmia in sé, ma la classificazione e il filtraggio preventivo del rumore prima ancora che questo influenzi l’interpretazione del tracciato.
Nello studio sono state confrontate diverse metodiche di apprendimento automatico: Random Forest, Support Vector Machine, Multi-Layer Perceptron, Gradient Boosting e reti neurali convoluzionali 1D.
Per addestrare tali algoritmi sono stati analizzati quattro differenti set di caratteristiche del segnale: la traccia grezza priva di pre elaborazione, le metriche della variabilità della frequenza cardiaca nel dominio del tempo, l’integrazione con il dominio della frequenza e i parametri di ricostruzione simbolica ricavati tramite Programmazione Genetica.
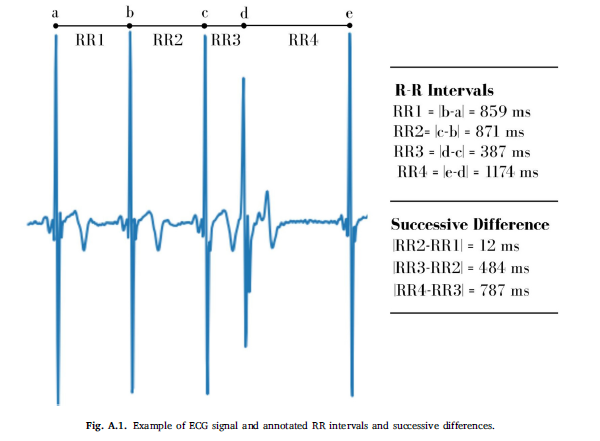
Successivamente, mediante l’analisi statistica ANOVA F-test, le metriche nel dominio del tempo legate agli intervalli tra i picchi R dell’ECG sono risultate le più discriminanti ed efficaci nell’isolare le componenti rumorose.
La Figura sotto riportata mostra la matrice di confusione degli algoritmi al variare delle feature valutate.
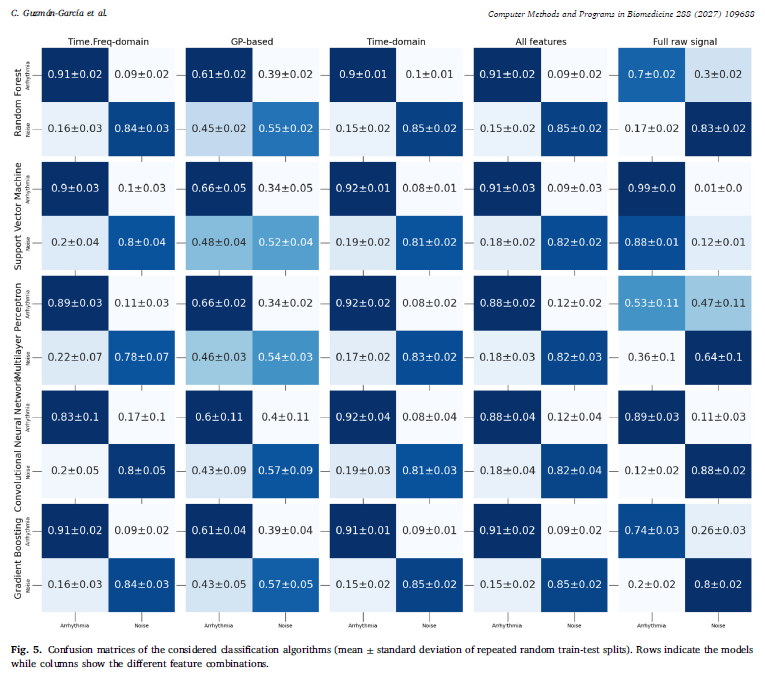
La matrice di confusione è la rappresentazione grafica della capacità del modello di posizionare correttamente i dati tra le classi reali e quelle predette. Dalla figura si osserva chiaramente come l’impiego delle caratteristiche HRV nei domini del tempo e della frequenza permetta a modelli quali Random Forest e Gradient Boosting di raggiungere valori elevati di accuratezza, superiori al 90% nella conferma delle aritmie vere e superiori all’80% nel riconoscimento dei segnali rumorosi.
Dall’analisi complessiva dei risultati è emerso che il modello Gradient Boosting, integrato con le feature HRV nei domini del tempo e della frequenza, offre il miglior bilanciamento operativo. Questo approccio garantisce un’elevata accuratezza generale e un F1 – score ottimale, unito a una latenza di inferenza estremamente ridotta inferiore a 10 millisecondi per campione e a un consumo di memoria di circa 1,7 megabyte. Al contrario, la rete convoluzionale basata sul segnale grezzo, pur ottenendo un’ottima accuratezza, richiede un’impronta di memoria superiore a 12 megabyte e tempi di calcolo che superano 1,8 secondi per campione, risultando troppo onerosa per l’hardware limitato dei dispositivi indossabili.
Per il Tecnico Sanitario di Radiologia Medica, la conoscenza di questo aspetto della tecnologia, rappresenta un tassello fondamentale nel processo di evoluzione professionale. Il TSRM è uno specialista protagonista nella catena di ottimizzazione e accuratezza del dato diagnostico. Nella moderna sanità digitale e nella diagnostica integrata, comprendere concetti come la sensibilità, ovvero la capacità di individuare correttamente gli artefatti, e la specificità, ossia la garanzia di preservare ogni evento patologico reale, è indispensabile per gestire i flussi informativi e le piattaforme di telemedicina.
Un approccio orientato all’eccellenza richiede che il TSRM non si limiti all’esecuzione tecnica dell’esame, ma conosca anche i meccanismi di condizionamento del segnale, il pre processing e il post processing del dato.
Sapere, ad esempio, come l’intelligenza artificiale interagisce con i biosensori, consente al professionista di prevenire errori sistematici, verificare la qualità dell’ECG prima della sua validazione e garantire che al medico giungano soltanto informazioni clinicamente rilevanti e prive di artefatti.
Fonte: Guzmán-García C, Martini C, Gaibazzi N, Quadrelli M, Morra A, Costantino C, Guaricci AI, Aversano L, Pecori R, Mordonini M, Cagnoni S. Machine learning and evolutionary computation for increased reliability of wearable devices for monitoring cardiac arrhythmias in the wild. Comput Methods Programs Biomed. 2027;288:109688. doi:10.1016/j.cmpb.2026.109688.
